Apuntes monitoreo con Grafana, Loki y Promtail
A lo largo de la vida profesional es normal ver muchos tipos de implementaciones en cuanto a desarrollo e infraestructura, en pocas palabras para infraestructura es normal que no exista monitoreo de servicios en servidores de alguna organización, esto es más común en servidores on-premise, por este motivo me hice algunas preguntas.
- ¿Cuánto tiempo toma armar un sistema de monitoreo?
- ¿Qué tan complicado puede ser implementar un sistema de monitoreo?
- ¿Qué capacidades de cómputo necesito para tener un sistema de monitoreo?
- ¿Cuántos sistemas de monitoreo existen y puedo utilizar?
Para este artículo hice una prueba de concepto aprovechando una rebaja en servidores VPS de CONTABO, armamos infraestructura simple, instalamos algunos honeypots para obtener datos, generamos tráfico para obtener métricas y crear gráficas.
| Servidor | Característica |
|---|---|
| CPU | AMD 4 Cores |
| RAM | 8GB |
| SSD | 150 GB |
| OS | Debian Trixie 13 |
¿Por qué tenemos que monitorear?
Tenemos que monitorear porque necesitamos enterarnos de lo que sucede en nuestra infraestructura antes de que los problemas aparezcan, los reclamos lleguen y existan incidentes de seguridad, monitorear nos permite:
- Detectar ataques en curso, desde ataques de fuerza bruta, escaneos de puertos, IPs maliciosas.
- Identificar problemas antes de que escalen, errores 5xx en servidores web, certificados SSL a punto de vencer, servicios caídos.
- Entender el comportamiento del servidor, tráfico y demanda de red, patrones de uso, dominios más consultados.
- Tener evidencia para tomar decisiones, datos reales sobre qué está pasando, no suposiciones.
- Responder más rápido ante incidentes, con dashboards centralizados la información está a un vistazo.
Muchas veces se piensa que armar un sistema de monitoreo trata de un sistema complejo que necesita de hardware especializado, licencias de uso para el software y conocimientos avanzados de seguridad, pero la idea es tener lo mínimo necesario para no estar a ciegas (para infraestructuras pequeñas).
Sistemas de monitoreo
Existen diferentes tipos de sistemas de monitoreo, algunos de propósito general, otros con propósito específico:
- Zabbix, plataforma de monitoreo de infraestructura que permite supervisar servidores, redes, aplicaciones, bases de datos y servicios. Utiliza agentes, SNMP y otros protocolos para recopilar métricas y generar alertas.
- Nagios - Icinga, soluciones de monitorización de infraestructura y servicios. Permiten verificar disponibilidad, estado y rendimiento mediante plugins. Icinga nació como un fork de Nagios y mantiene compatibilidad con gran parte de su ecosistema.
- PandoraFMS, plataforma de monitorización integral para infraestructura, redes, servidores, aplicaciones y servicios. Permite recopilar métricas, generar alertas, visualizar estados y realizar monitorización tanto local como remota.
- Grafana - Loki - Promtail, stack orientado principalmente a observabilidad y gestión de logs. Grafana proporciona dashboards con visualización, Loki almacena y consulta logs, Promtail recopila y envía los logs hacia Loki.
- Wazuh, permite monitorizar endpoints, analizar logs, detectar amenazas, realizar análisis de vulnerabilidades, file integrity monitoring (FIM) y generar alertas de seguridad.
- ELK Stack (Elasticsearch, Kibana, Beats y Logstash), plataforma de gestión y análisis de logs y datos. Elasticsearch almacena e indexa datos, Logstash realiza ingesta y transformación, Beats recopila información desde sistemas y servicios, y Kibana proporciona visualización, dashboards y análisis.
No queremos alargar este artículo, el monitoreo simple que haremos será con Grafana - Loki - Promtail, con datos de los registros de sistema, utilizando agentes con acceso a los datos de los servicios que queremos monitorear.
Nota importante: Actualmente, Promtail está en proceso de reemplazo dentro del ecosistema Grafana por Grafana Alloy.
Grafana - Loki - Promtail
La solución se compone de tres herramientas del ecosistema de Grafana, todas de código abierto:
| Componente | Función | Puerto |
|---|---|---|
| Promtail | Agente que recolecta logs del sistema y los envía a Loki | 9080 |
| Loki | Motor de almacenamiento e indexación de logs | 3100 |
| Grafana | Interfaz web para visualización y dashboards | 3000 |
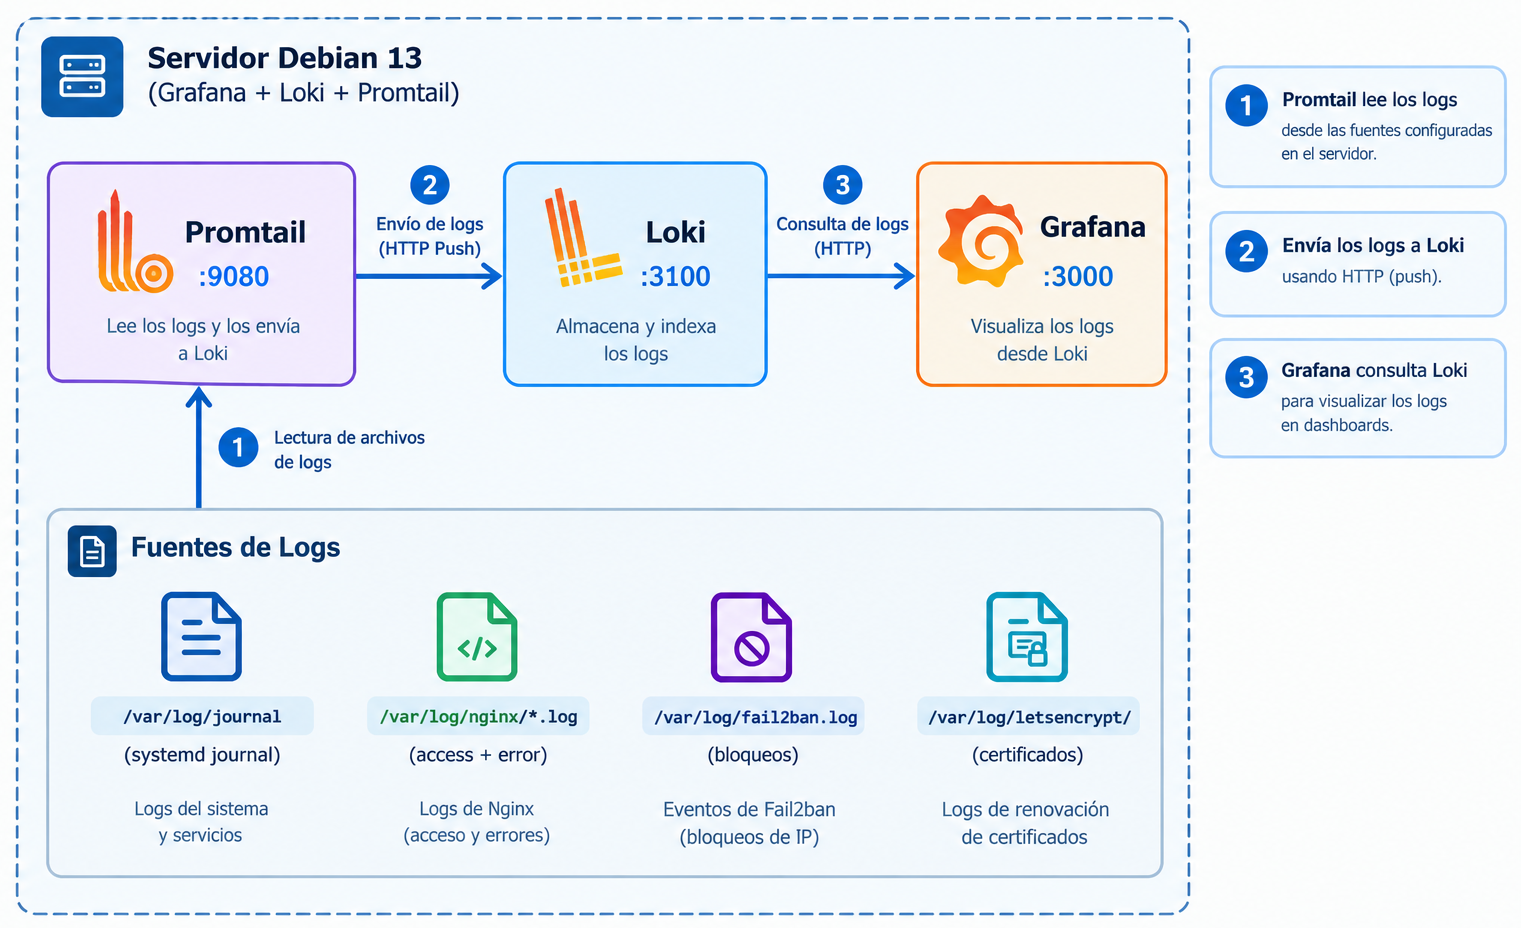
El flujo es simple: Promtail lee los archivos de log y el journal de systemd, los envía a Loki que los almacena e indexa, y Grafana consulta a Loki para mostrar la información en dashboards.
¿Por qué solo Grafana - Loki - Promtail?
- No requiere agentes de métricas adicionales, toda la información proviene de logs que ya existen en el servidor.
- Bajo consumo de recursos, Loki no indexa el contenido completo de los logs, solo los labels, lo que lo hace mucho más ligero que Elasticsearch.
- Instalación simple, los tres componentes se instalan desde el repositorio oficial de Grafana con
apt. - LogQL, el lenguaje de consultas de Loki es potente y permite extraer métricas directamente de los logs.
¿Qué vamos a monitorear?
Nuestra prueba solo va a monitorear servicios como SSH, Nginx, Fail2ban y Docker.
1. SSH
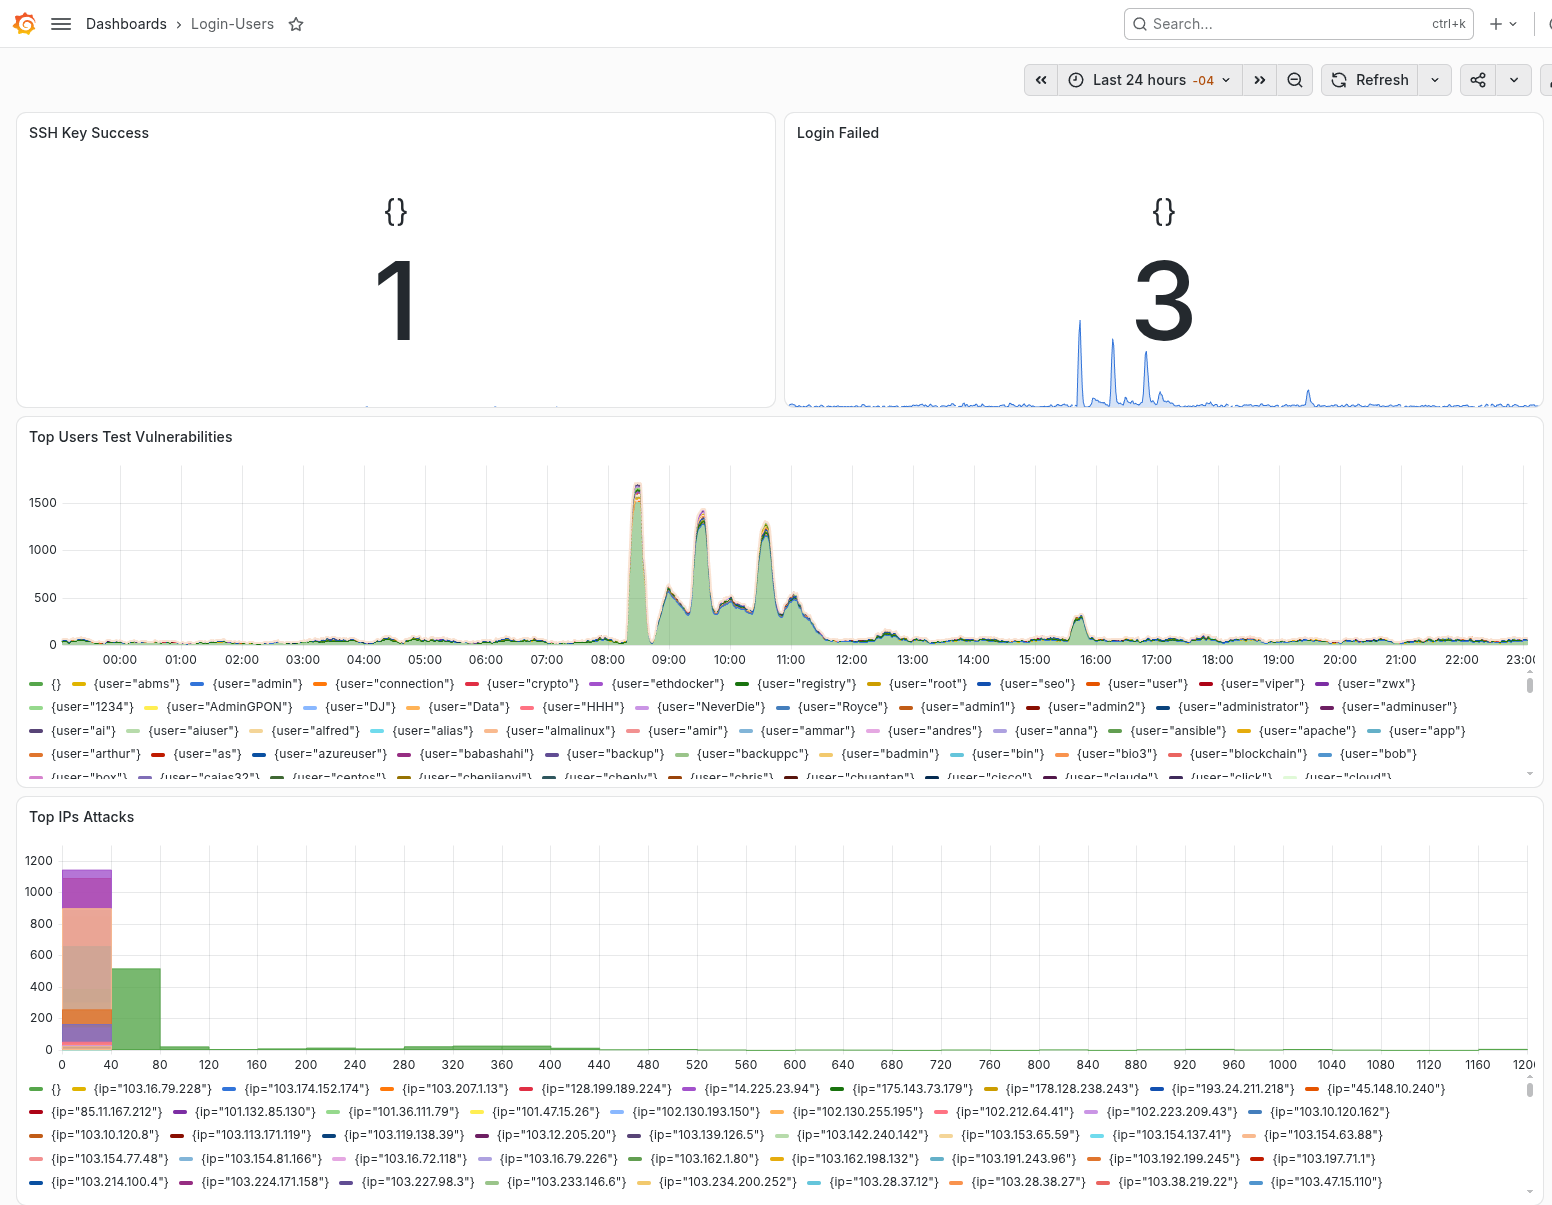
Muchos conocemos SSH, nos permite conectar de forma remota a un servidor que tiene instalado este servicio, el puerto por defecto es el 22. Monitorear este servicio es muy importante porque permite detectar:
- Intentos de login fallidos, fuerza bruta.
- Logins exitosos, verificar que solo acceden usuarios autorizados.
- IPs de origen, de cada intento.
- Usuarios probados, por atacantes.
2. Nginx
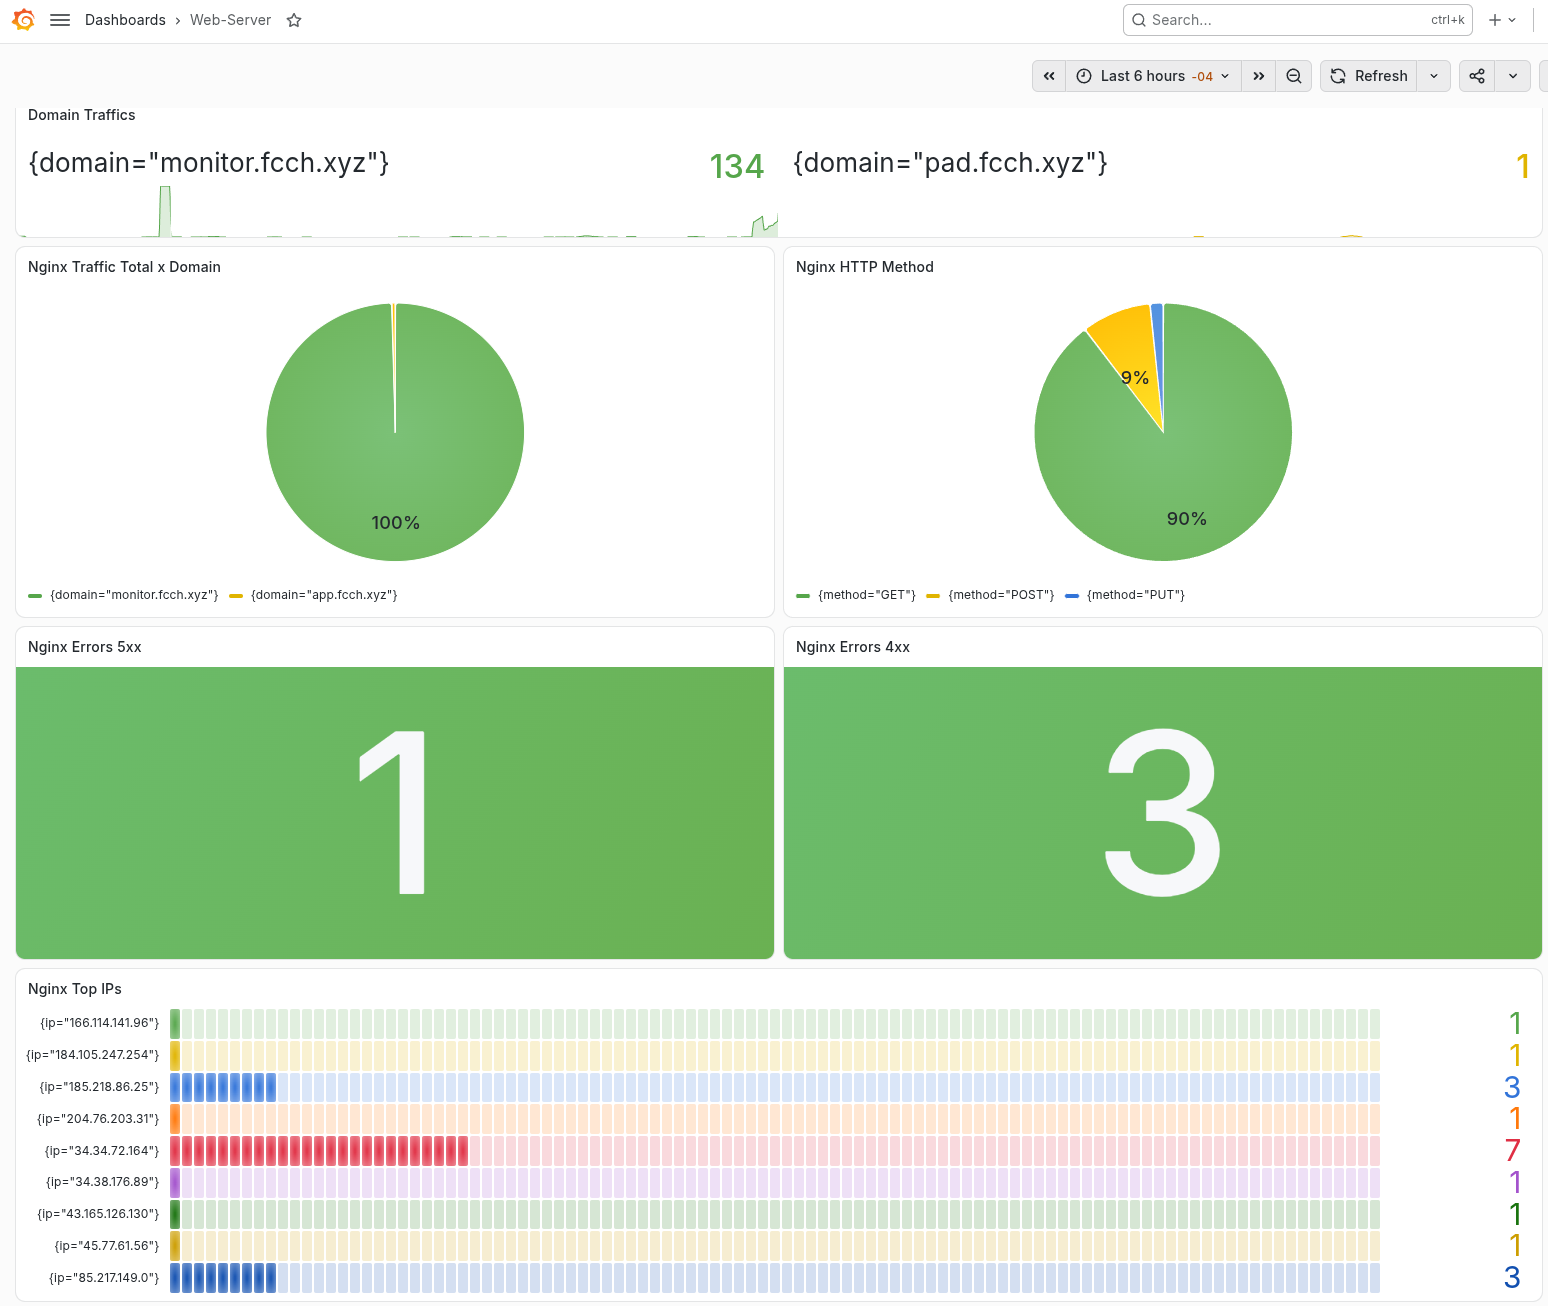
Para servidores web lo mínimo que conviene monitorear es el tráfico:
- Requests por segundo/minuto, detectar alta o baja demanda de tráfico.
- Códigos de estado HTTP, cuántos errores 4xx y 5xx se están produciendo.
- Top IPs, identificar quién está generando más tráfico.
- Top URLs, qué recursos son los más solicitados.
- Error logs, visualizar errores del servidor en tiempo real.
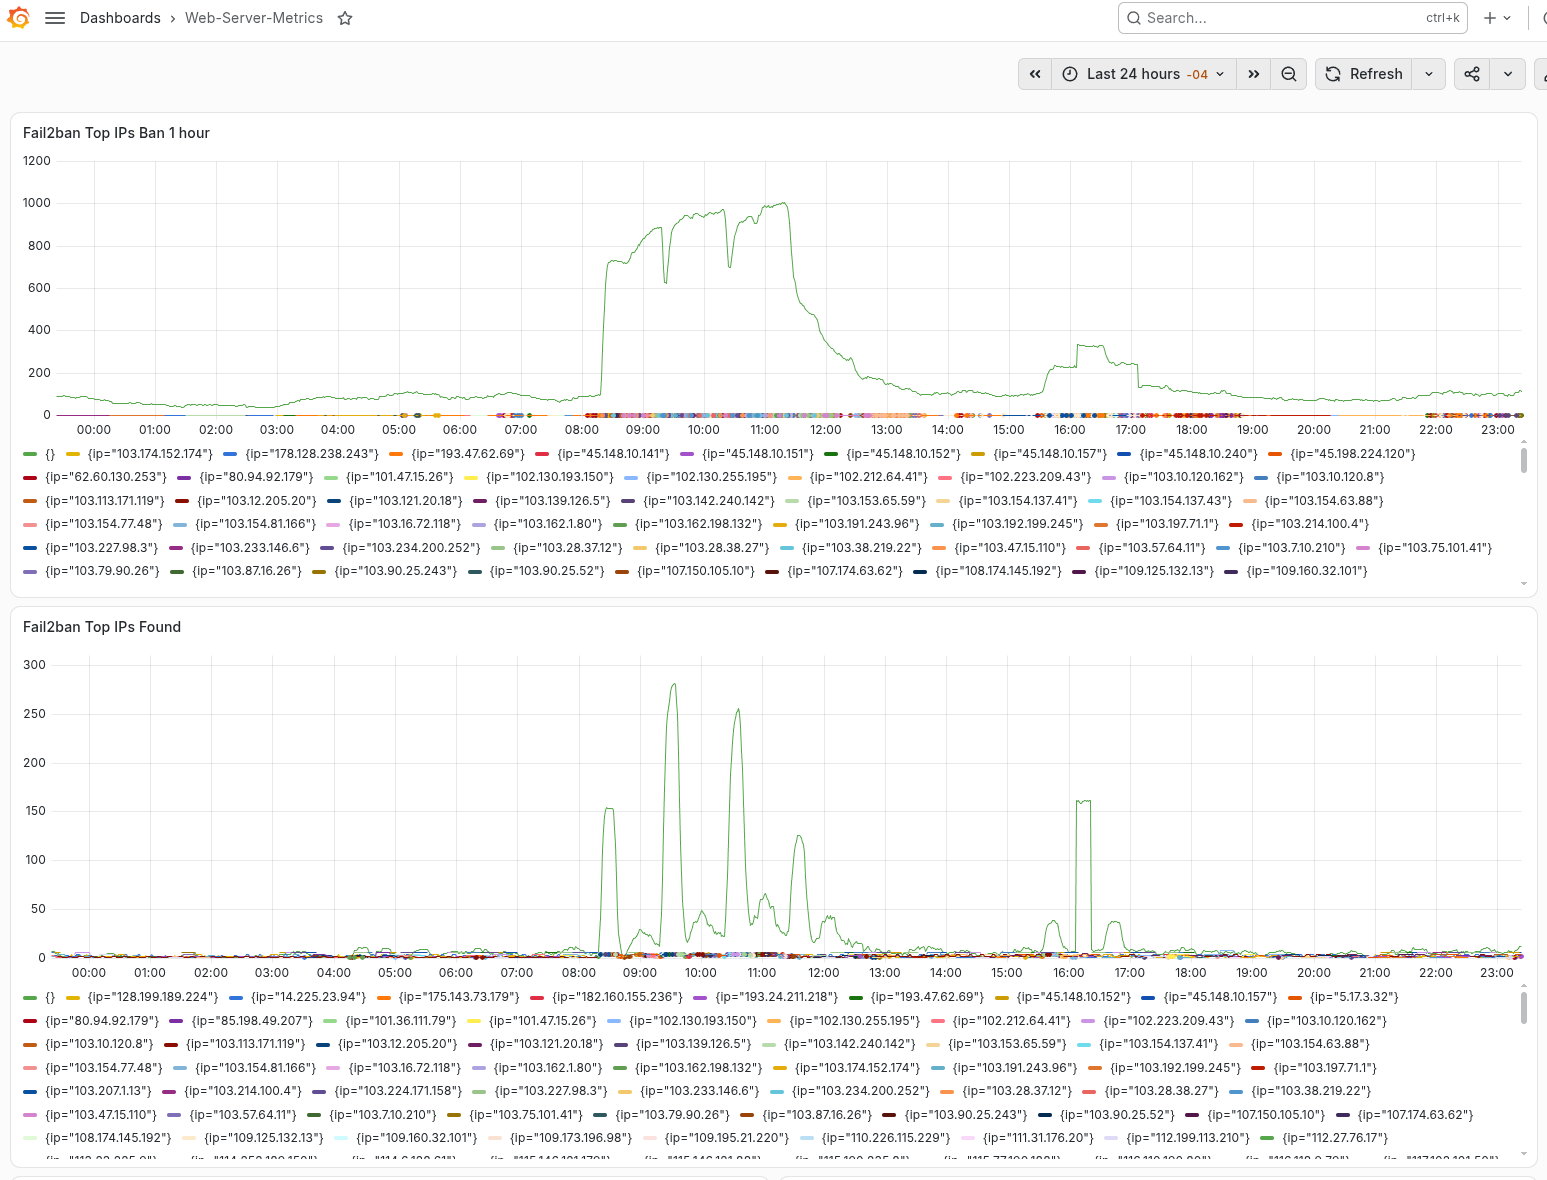
3. Fail2ban
Protección contra ataques de fuerza bruta, complementa el monitoreo mostrando las acciones de defensa automática:
- IPs baneadas, quién fue bloqueado y cuándo.
- IPs detectadas, intentos sospechosos antes del baneo.
- Tendencias, si los ataques están aumentando o disminuyendo.
4. Docker
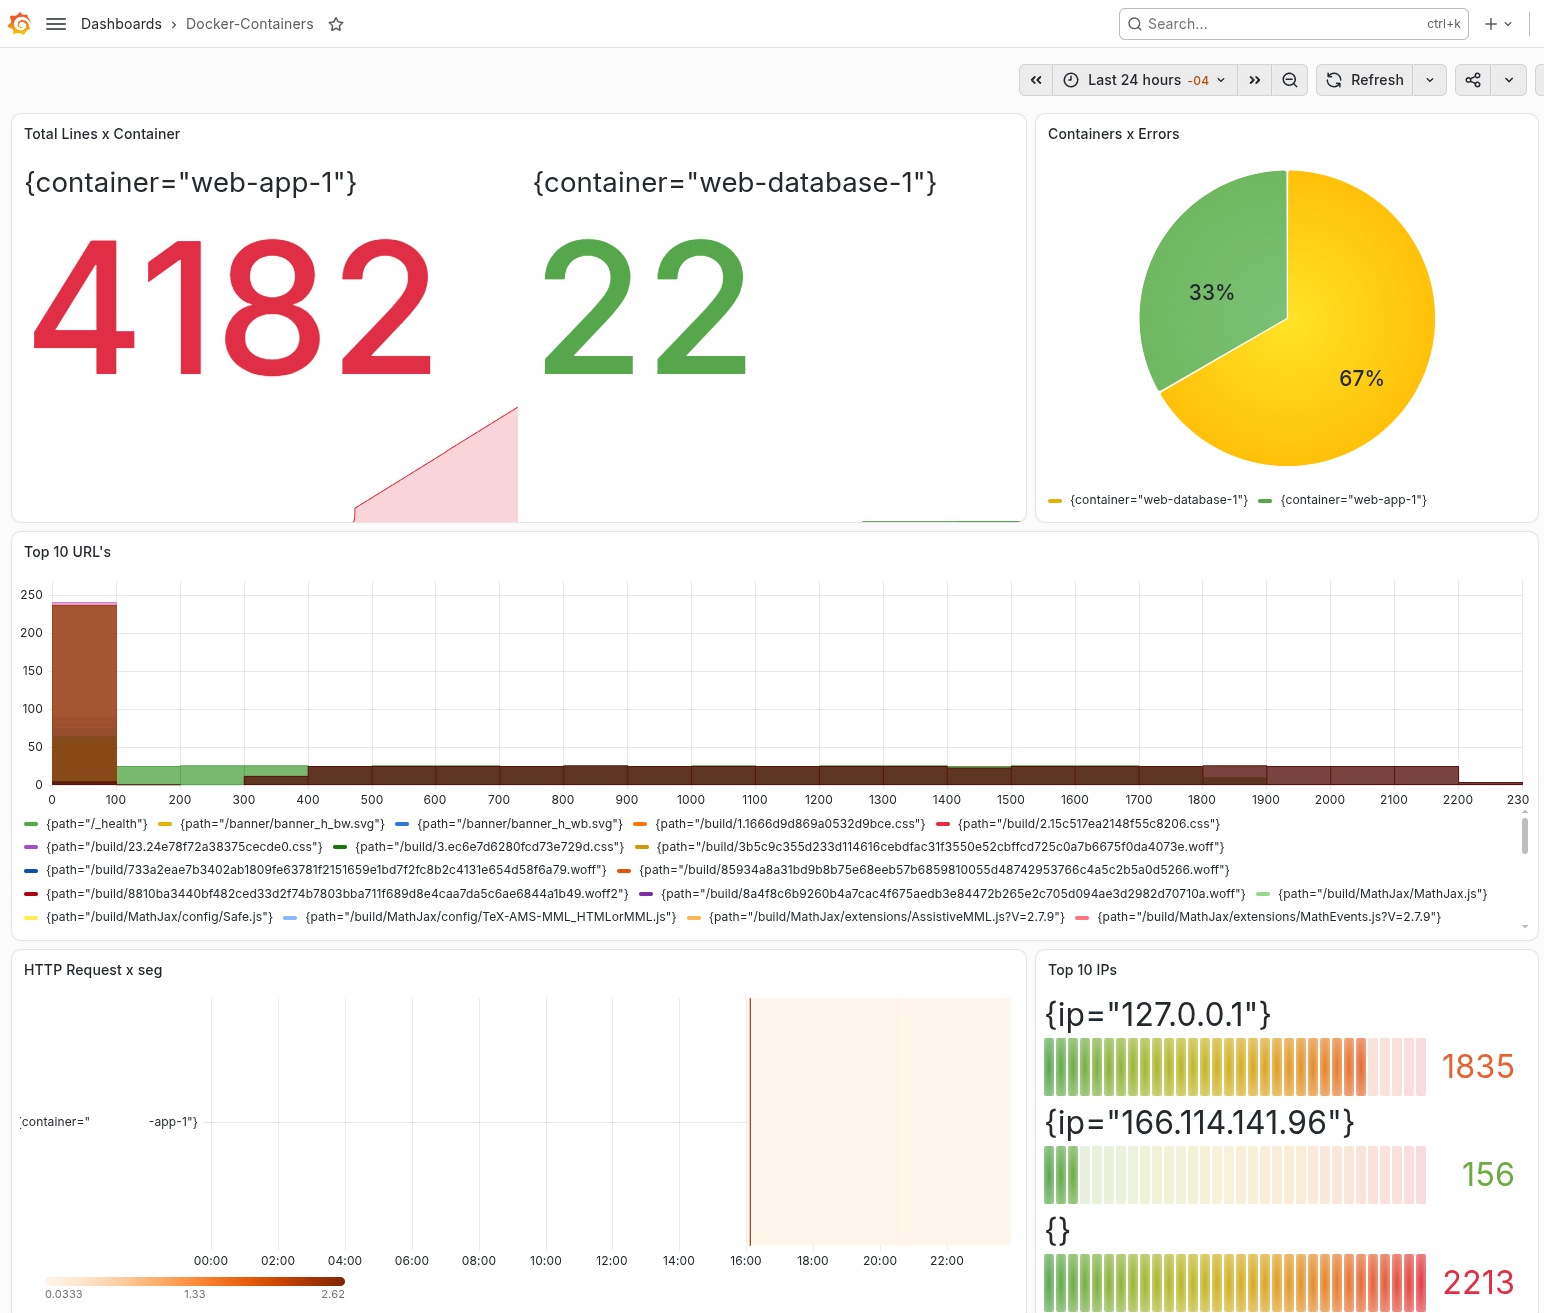
Para un monitoreo de contenedores simple, podemos pedirle a docker que escriba sus registros de sistema en journal de systemd, con una configuración no muy compleja podremos monitorear los contenedores, códigos de estado, volúmenes.
Por defecto el Logging Driver de Docker está configurado para "json-file", esta configuración debe estar con "journald", se puede verificar con algunos comandos.
1# Ver el driver de logs activo
2docker info --format '{{.LoggingDriver}}'
3
4# Ver si ya existe el archivo de config del daemon
5sudo cat /etc/docker/daemon.json 2>/dev/null || echo "No existe daemon.json todavía"
Comúnmente el archivo "daemon.json", si es necesario se debe crear.
1sudo tee /etc/docker/daemon.json > /dev/null <<'EOF'
2{
3 "log-driver": "journald"
4}
5EOF
Si el archivo ya existe con otros datos, no se debe sobrescribir, se debe editar el contenido en base al comando anterior. Ruta del archivo a editar /etc/docker/daemon.json
Recomendable validar si el JSON es correcto.
1sudo python3 -c "import json; json.load(open('/etc/docker/daemon.json')); print('JSON válido')"
Aplicando cambios y verificando los datos:
1sudo systemctl restart docker
2docker info --format '{{.LoggingDriver}}' # Salida: "journald"
Nota importante: El driver de registro de sistema se asigna al crear contenedores, es posible que se deba recrear contenedores existentes para que se creen con el nuevo driver.
1# Para un contenedor suelto
2docker stop <nombre> && docker rm <nombre>
3# y volver a lanzarlo
4
5# Si usas docker compose
6docker compose up -d --force-recreate
Por último se deben verificar los cambios:
1docker inspect --format '{{.HostConfig.LogConfig.Type}}' <nombre_o_id>
Con estos detalles podemos crear un dashboard para contenedores también.
Instalación de Grafana y sus componentes
Los tres componentes se instalan desde el repositorio oficial de Grafana mediante apt en Debian. Los paquetes .deb ya incluyen los archivos de unidad para systemd.
Repositorio de Grafana
1sudo apt install -y apt-transport-https wget gnupg
2sudo mkdir -p /etc/apt/keyrings
3sudo wget -O /etc/apt/keyrings/grafana.asc https://apt.grafana.com/gpg-full.key
4sudo chmod 644 /etc/apt/keyrings/grafana.asc
Crear el archivo /etc/apt/sources.list.d/grafana.sources:
1X-Repolib-Name: grafana
2Types: deb
3Components: main
4Suites: stable
5URIs: https://apt.grafana.com
6Signed-By: /etc/apt/keyrings/grafana.asc
7Enabled: yes
Actualizamos e instalamos los paquetes:
1sudo apt update
2sudo apt install -y grafana loki promtail
Archivos de configuración
- Grafana, archivo de configuración en
/etc/grafana/grafana.ini - Loki, archivo de configuración en
/etc/loki/config.yml - Promtail, archivo de configuración en
/etc/promtail/config.yml
Crear directorios de datos para Loki
1sudo mkdir -p /var/lib/loki/{chunks,rules,compactor}
2sudo chown -R loki:loki /var/lib/loki
Habilitar e iniciar servicios
1sudo systemctl enable grafana-server loki promtail
2sudo systemctl start grafana-server loki promtail
Configuración adicional para Loki
La configuración de Loki define cómo se almacenan e indexan los registros de sistema.
Puntos importantes:
- Retención de 7 días (
168h): suficiente para un servidor personal y no consume demasiado disco. - Esquema v13 con TSDB, el formato más reciente y eficiente para indexación.
- Almacenamiento en filesystem: ideal para un solo servidor, sin necesidad de almacenamiento distribuido.
- Telemetría deshabilitada, no envía datos de uso a Grafana Labs.
Configuración de Promtail
Promtail es el agente que recolecta los registros de sistema, su configuración define qué archivos leer y cómo procesarlos.
La sección scrape_configs define los jobs de recolección, cada job apunta a una fuente de registro de sistema y asigna labels que permiten filtrar en Grafana:
| Job | Fuente | Labels clave |
|---|---|---|
| journal | /var/log/journal | unit, host, level |
| nginx-*-access | /var/log/nginx/*-access.log | domain, log_type=access |
| nginx-*-error | /var/log/nginx/*-error.log | domain, log_type=error |
| fail2ban | /var/log/fail2ban.log | service=fail2ban |
Nota importante: Debian 13 (Trixie) ya no incluye rsyslog por defecto. No existe /var/log/syslog ni /var/log/messages. Todos los logs del sistema se gestionan a través de systemd-journald, por eso se usa el scraper de tipo journal en Promtail para leer logs de SSH y otras unidades systemd.
Verificación del stack
Una vez instalado y configurado, se puede verificar que todo funciona correctamente:
1curl http://localhost:3000/login
Dashboards del proyecto
El proyecto incluye dashboards listos para importar:
- Login Users: seguridad SSH con paneles de logins exitosos, fallidos, top IPs atacantes y usuarios probados.
- Web Server: monitoreo completo de Nginx y Fail2ban con requests por segundo, códigos de estado HTTP, top URLs, top IPs y error logs.
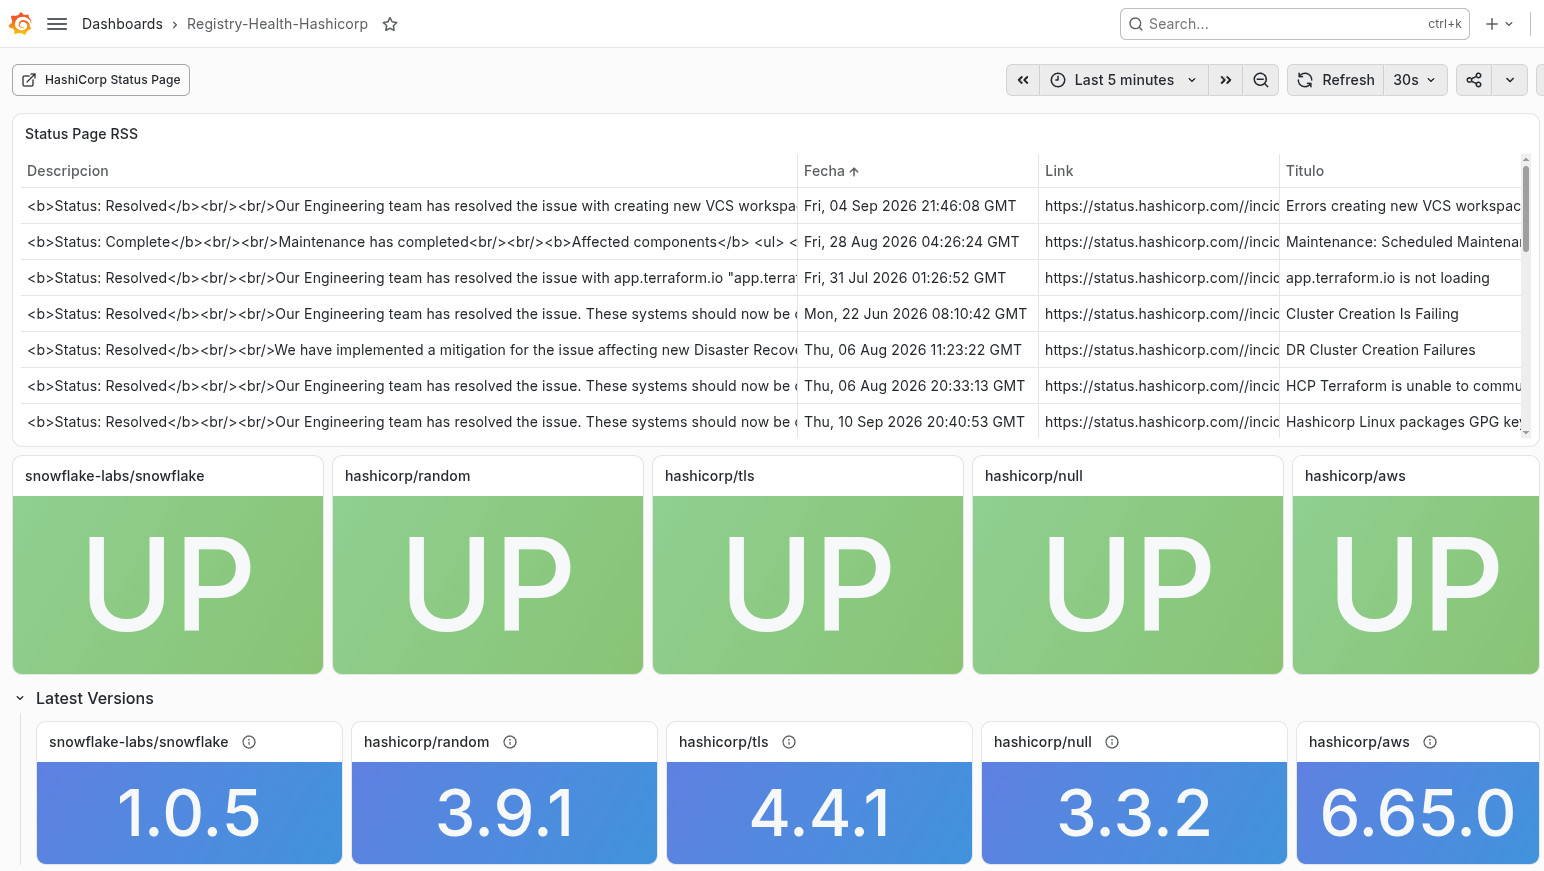
- Registry Health: disponibilidad de providers del Terraform Registry (usando datasource Infinity).
Escalando a múltiples servidores
Esta misma solución se puede escalar para monitorear múltiples servidores instalando solo Promtail en cada servidor remoto y apuntándolo al Loki central.
Solo hay que cambiar instance_addr de 127.0.0.1 a 0.0.0.0 en Loki y proteger el acceso con firewall.
Conclusión
No hace falta una infraestructura compleja para tener visibilidad sobre lo que pasa en un servidor. Con Grafana, Loki y Promtail se puede implementar un sistema de monitoreo basado en logs que cubre lo esencial: seguridad de acceso, tráfico web, protección contra ataques y estado de certificados.
Lo importante es empezar con lo mínimo. Un dashboard con intentos de SSH fallidos y errores de Nginx ya es infinitamente mejor que no tener nada.
¿Cuánto tiempo nos tomó? Puedo decir que me tomó más tiempo crear el artículo que desplegar todo lo necesario:
Instalación y configuración del servidor, con Ansible 20 minutos, ya tenía un proyecto con todo lo necesario, el sistema de monitoreo fueron como 5 horas y un poco más, ya que no conocíamos la herramienta, tocó leer, probar y preguntar a la IA también.
Nota importante: Este artículo se hizo largo, en otro dejaré las configuraciones de cada servicio incluyendo la configuración del reverse proxy de Nginx para tener más detalle de cada configuración.
Referencias
- Grafana
- Loki - Documentación Oficial
- Promtail - Documentación Oficial
- LogQL - Lenguaje de Consultas de Loki